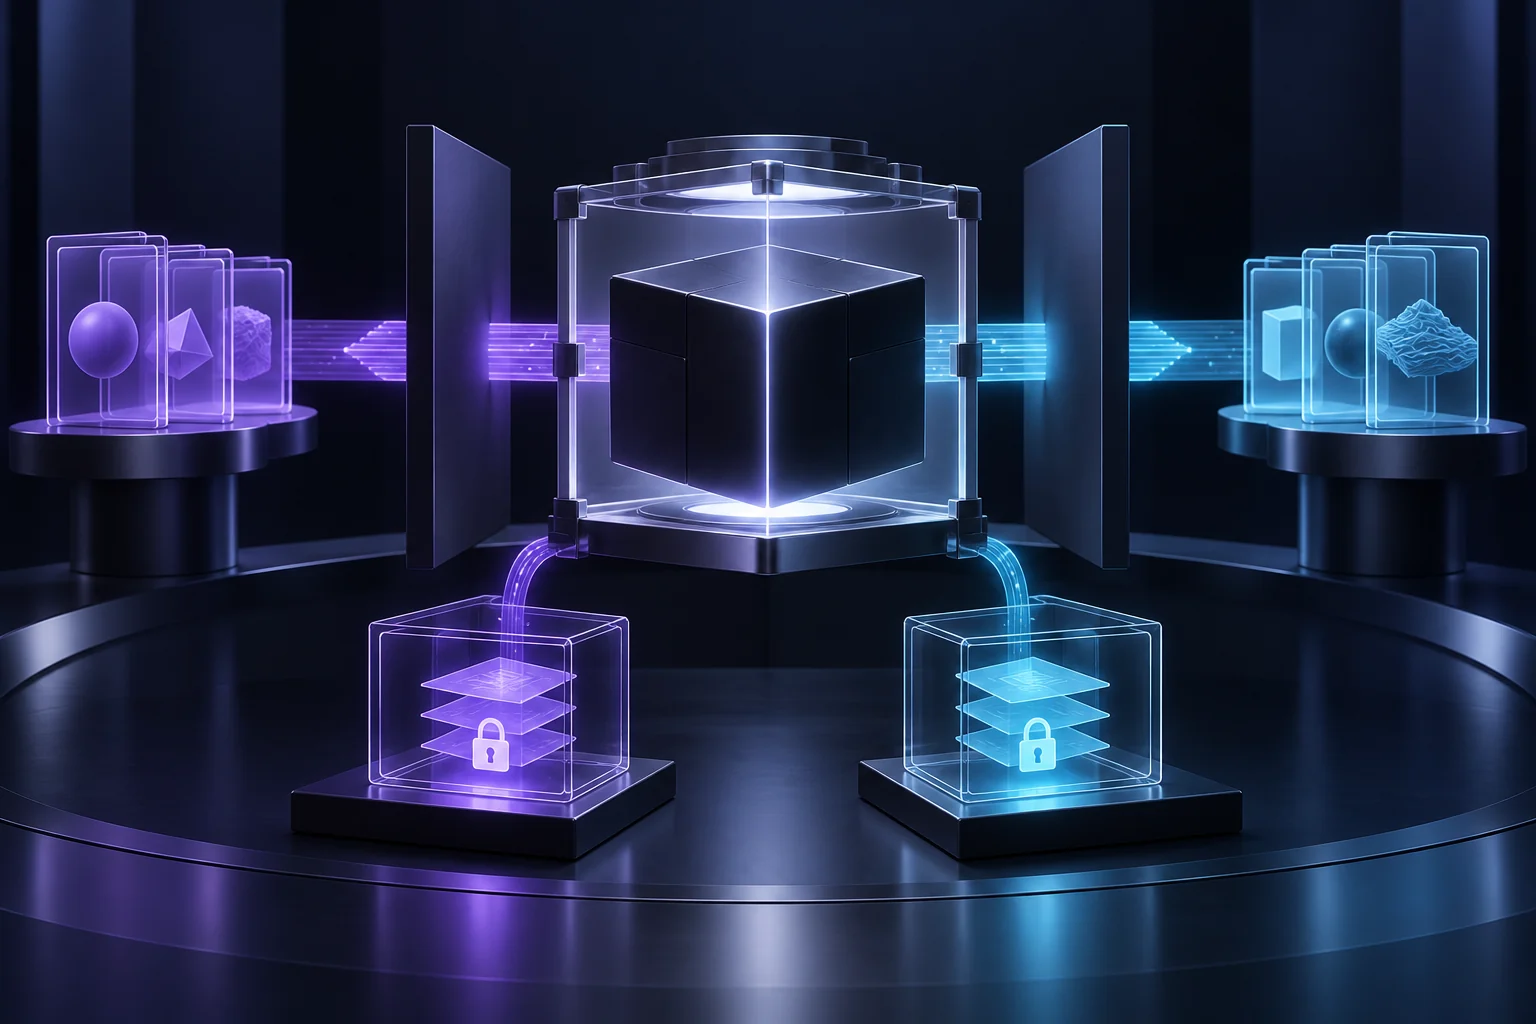
Jak działa protokół krok po kroku
Punktem wyjścia jest wspólna polityka określająca dokładnie, jaki kod, sterowniki, obraz maszyny i sprzęt mogą uczestniczyć w teście. Z tych elementów powstają sprawdzalne skróty. Dostawca modelu i evaluator nie przesyłają jeszcze swoich sekretów — najpierw żądają dowodu, że środowisko uruchomiono w uzgodnionej konfiguracji.
Dopiero po zdalnej atestacji każda strona przekazuje klucz pozwalający odszyfrować własny artefakt. Wagi modelu, kod inferencji i prywatne pytania istnieją razem wyłącznie w enklawie. Na zewnątrz trafia wcześniej zdefiniowany rezultat, na przykład zagregowany raport, a nie surowe prompty, odpowiedzi czy parametry modelu.
Gdzie naprawdę znajduje się zaufanie
Określenie „podwójnie ślepa” nie oznacza, że zaufanie znika. Zostaje przeniesione z relacji między organizacjami do zaufanej bazy obliczeniowej: procesora, GPU, firmware’u, mechanizmu atestacji, obrazu maszyny i kodu wykonującego test. Błąd w którejkolwiek z tych warstw może podważyć prywatność albo integralność wyniku.
Znaczenie ma również możliwość odtworzenia buildów oraz zakres przeglądu. Jeżeli własnościowy komponent jest dostarczony wyłącznie jako binarium, evaluator może potwierdzić, że uruchomiono ten sam artefakt, ale niekoniecznie zrozumieć każdy jego efekt. Dlatego techniczna izolacja powinna współistnieć z audytem kodu, kontrolą dostępu i jasną odpowiedzialnością prawną.
Siedem warstw bezpiecznej ewaluacji
Uproszczony przebieg pilota: zasoby obu stron są weryfikowane i odsłaniane dopiero w chronionym środowisku.
- 01Zdefiniowanie polityki
Strony ustalają dozwolony kod, sprzęt i wynik.
- 02Reprodukowalny build
Komponenty otrzymują sprawdzalne skróty.
- 03Uruchomienie enklawy
GPU i maszyna startują w zadanej konfiguracji.
- 04Zdalna atestacja
Każda strona sprawdza środowisko przed odszyfrowaniem.
- 05Dostarczenie modelu
Wagi pozostają niewidoczne dla evaluatora.
- 06Dostarczenie benchmarku
Pytania pozostają niewidoczne dla dostawcy.
- 07Kontrolowany wynik
Ujawniany jest uzgodniony artefakt oceny.
Jak oceniać jakość takiego dowodu
Najpierw należy oddzielić trzy pytania: czy benchmark pozostał tajny, czy model pozostał tajny oraz czy sam benchmark mierzy właściwe zachowanie. Enklawa może mocno wesprzeć pierwsze dwa, lecz nie naprawi źle zaprojektowanego testu, nietrafnej próbki ani kryterium, które nie przekłada się na realne ryzyko.
Profesjonalny raport powinien podawać wersję modelu, wersję benchmarku, pełną politykę atestacji, listę komponentów objętych przeglądem, sposób agregowania wyników oraz znane ograniczenia. Bez tego kryptografia może wyglądać imponująco, ale odbiorca nadal nie potrafi ocenić, co rzeczywiście sprawdzono.
Gdzie ten wzorzec ma największy sens
Najbardziej naturalne zastosowania to testy rządowe, cyberbezpieczeństwo, zdrowie, finanse i inne obszary, w których zestaw testowy sam zawiera informacje wrażliwe. Może to być również sposób na porównanie zamkniętych modeli przez instytucję, która nie może przejąć ich wag ani wysłać poufnych danych do zewnętrznego API.
Przed wdrożeniem warto przeprowadzić mały pilot: jeden model, jeden benchmark, z góry zdefiniowany raport i scenariusz awaryjny. Dopiero później należy rozbudowywać proces o wiele laboratoriów i wersji modeli. Najtrudniejsze pytania mogą dotyczyć nie mocy obliczeniowej, lecz zgód, licencji, odpowiedzialności za wyciek i prawa do zakwestionowania wyniku.
Co warto obserwować dalej
Kolejnym krokiem powinny być niezależne replikacje na innym sprzęcie i z innymi dostawcami chmury. Ważna będzie też standaryzacja raportu z atestacji, tak aby urząd, audytor lub klient mógł porównać dwa testy bez interpretowania całej infrastruktury od początku.
Prawdziwym testem dojrzałości będzie sytuacja sporna: model otrzymuje słaby wynik, dostawca kwestionuje benchmark, a evaluator wskazuje możliwą zmianę środowiska. Dobry protokół musi wtedy umożliwić niezależne odtworzenie przebiegu bez ujawniania sekretów żadnej strony.
Kto czego nie musi ujawniać
Wartość układu polega na ograniczeniu asymetrii informacji bez przekazania najwrażliwszych aktywów drugiej stronie.
Otrzymuje kontrolowany wynik, nie prywatny zestaw testowy.
Może sprawdzić uruchamiany stos i warunki testu.
Uruchamia test po pomyślnej atestacji.
Od umów o poufności do reguł wykonywanych przez maszynę
Poufny benchmark rozwiązuje jeden problem i tworzy drugi. Chroni pytania przed publicznym obiegiem, lecz zamknięty model zwykle działa w infrastrukturze producenta, który technicznie może zobaczyć wejście. Umowy, deklaracje braku logowania i procedury organizacyjne ograniczają ryzyko, ale nie dają evaluatorowi samodzielnie sprawdzalnego dowodu, że pytania nie zostały zapisane albo użyte później. Alternatywa — przekazanie wag modelu — przenosi największe ryzyko własności intelektualnej na producenta i często blokuje współpracę jeszcze przed testem.
Double-Blind Evaluation zmienia ten spór z negocjacji o wzajemnym zaufaniu w problem egzekwowania uzgodnionej polityki. Każda strona udostępnia swój zasób enklawie dopiero po niezależnym sprawdzeniu jej atestowanego stanu; szyfrowany transport i sprzętowe szyfrowanie pamięci chronią dane podczas przesyłania oraz obliczeń. To ważna zmiana: poufność nie wynika wyłącznie z obietnicy drugiej organizacji, lecz z połączenia izolowanego sprzętu, atestacji i ograniczonego programu. Nadal istnieją podmioty, którym trzeba ufać, ale zakres tego zaufania można nazwać, udokumentować i poddać kontroli.
Atestacja mówi, co uruchomiono — nie czy to jest dobre
Zdalna atestacja zaczyna się od sprzętowego korzenia zaufania. Procesor podpisuje pomiary kolejnych warstw uruchamianego stosu, a obie strony porównują je z wartościami oczekiwanymi. Świeży nonce utrudnia ponowne użycie starego raportu, a tymczasowy klucz wiąże szyfrowany kanał z konkretną instancją enklawy. W praktyce evaluator nie musi wierzyć administratorowi chmury na słowo, że działa właściwy obraz: może zweryfikować podpis i skróty przed odszyfrowaniem benchmarku.
Ten dowód ma jednak precyzyjny zakres. Potwierdza tożsamość sprzętu i zgodność zmierzonego oprogramowania, nie poprawność każdego wiersza kodu. Jeśli zatwierdzony program zawiera błąd, wyprowadza dane dostępnym kanałem albo źle liczy metrykę, atestacja wiernie potwierdzi uruchomienie właśnie tego wadliwego programu. Dlatego reprodukowalny build jest użyteczny tylko razem z przeglądem źródeł, jasną polityką sieciową i testami negatywnymi pokazującymi, że nieautoryzowany wynik rzeczywiście nie może opuścić enklawy.
Interfejs próbny oddziela przygotowanie testu od sekretu modelu
Evaluator musi napisać kod testowy, zanim zobaczy prawdziwy model. Raport opisuje w tym celu interfejs próbny: producent publikuje zgodny kontrakt wejścia i wyjścia, na którym można przygotować logikę ewaluacji bez dostępu do wag. Przed wykonaniem strony uzgadniają zależności, format danych i dozwolone operacje. Taki kontrakt ogranicza improwizację w ostatniej chwili i pozwala wykryć problemy kompatybilności zanim wrażliwe zasoby znajdą się w jednym środowisku.
Najtrudniejsza część pojawia się wtedy, gdy także kod inferencji lub metoda oceny zawiera tajemnicę. Autorzy dopuszczają kontrolowane redakcje, lecz ukryty fragment może korzystać tylko z listy metod, które nie otwierają kanału sieciowego ani innej drogi wycieku. To rozsądny kompromis, nie pełna przejrzystość. Im większa część programu pozostaje niewidoczna, tym mocniejsze muszą być ograniczenia jej możliwości. W dojrzałym procesie zatwierdza się nie tylko plik, lecz również jego uprawnienia, zależności i wszystkie możliwe wyjścia.
Sam wynik może stać się kanałem wycieku
Ochrona wejść nie wystarcza, jeżeli program może zwrócić dowolnie obszerny rezultat. Surowe odpowiedzi modelu mogłyby ujawnić elementy pytań; szczegółowe logi mogłyby zdradzić metodę benchmarku; seria adaptacyjnych zapytań o metrykę mogłaby stopniowo odsłaniać strukturę tajnego zbioru. Dlatego pilotaż zakłada wcześniej uzgodniony, ograniczony wynik, na przykład zagregowane miary. Polityka wyjścia powinna określać pola, precyzję, minimalne grupy i liczbę dopuszczonych uruchomień, a nie tylko nazwę raportu.
Ograniczenie wyniku ma koszt naukowy. Evaluator, który otrzymuje wyłącznie sumę, ma mniej materiału do diagnozy błędów, badania nietypowych odpowiedzi lub powtarzania analizy. Rozwiązaniem może być stopniowany dostęp: podstawowy raport dla wszystkich stron, bardziej szczegółowy artefakt pozostający w kontrolowanym repozytorium oraz procedura ujawnienia konkretnego przypadku po wspólnej zgodzie. To pokazuje, że prywatność wyjścia jest decyzją metodologiczną. Zbyt luźna osłabia poufność, a zbyt ciasna może osłabić niezależność oceny.
Co dokładnie zostało zademonstrowane w pilocie
W opisanym wdrożeniu Gemini 2.5 Flash Lite uruchomiono na poufnej karcie NVIDIA H100 w maszynie Google Cloud z pamięcią hosta chronioną przez Intel TDX. Warstwę koordynacji zapewniał PySyft. W partnerstwie z AVERI i MLCommons użyto prywatnej puli rezerwowej AILuminate; raport techniczny podaje w różnych miejscach oznaczenia AIRR 1.0 i AIRR 1.4, dlatego wersji nie należy rozstrzygać bez korekty autorów. Singapore AI Safety Institute dostarczył osobny zestaw dotyczący wywoływania szkodliwych treści w lokalnym kontekście. Po atestacji wagi i prompty przesyłano szyfrowanymi kanałami do enklawy, a po ocenie środowisko wyłączano.
Pilot wykazał praktyczną możliwość zachowania wzajemnej poufności pomiędzy właścicielem modelu a właścicielem benchmarku, ale jego zaufana baza nie była w pełni niezależna od Google. Autorzy podają, że nie wszystkie własnościowe implementacje metod dało się przejrzeć lub objąć listą dozwolonych wywołań, obrazy systemu gościa nie były niezależnie reprodukowalne, a usługi Google uczestniczyły w podpisywaniu i weryfikacji atestacji. Nie jest to publikacja wyniku bezpieczeństwa Gemini ani dowód uniwersalności protokołu. Mocniejszy dowód wymaga powtórzeń przez inne laboratoria i dostawców infrastruktury.
Czego nie da się zbadać bez szerszego dostępu
Nie każda ewaluacja jest zestawem promptów zakończonym jedną metryką. Badanie aktywacji, steering reprezentacji, analiza prawdopodobieństw tokenów albo deterministyczna inspekcja offline może wymagać bezpośredniego dostępu do wag i wewnętrznych stanów. Raport sam wskazuje, że takie audyty są jednym z powodów, dla których część evaluatorów prosi o kopię modelu. Enklawa może rozszerzyć zestaw możliwych testów, ale nie powinna stać się argumentem za zastąpieniem wszystkich głębszych form dostępu.
Istnieje także różnica między integralnością pomiaru a trafnością jego znaczenia. Tajny benchmark może pozostać całkowicie niewidoczny i nadal mierzyć zachowanie zbyt wąskie, podatne na zmianę promptu albo oderwane od warunków wdrożenia. Ocena powinna zatem opisywać konstrukt, próbę, wersję modelu, ustawienia inferencji i niepewność. Bez tych informacji „kryptograficznie sprawdzone” łatwo zacznie brzmieć jak certyfikat jakości, choć kryptografia chroni przebieg, a nie gwarantuje mądrości projektu badawczego.
Kiedy warto wdrażać ten wzorzec
Najlepszym kandydatem jest test, w którym obie tajemnice mają realną wartość: ujawnienie pytań skróciłoby życie benchmarku lub naruszyło bezpieczeństwo, a przekazanie wag stworzyłoby nieakceptowalne ryzyko. Przed rozpoczęciem strony powinny ustalić model zagrożeń, właściciela każdej warstwy, dopuszczone wersje firmware’u, sposób budowania kodu, politykę wyjścia, retencję logów, procedurę przerwania i sposób rozstrzygania sporu. Koszt tej koordynacji będzie nieproporcjonalny dla rutynowego, publicznego benchmarku.
Krytyczna ocena pilota jest więc pozytywna, ale warunkowa. Protokół usuwa ważną barierę instytucjonalną i może poprawić jakość nadzoru nad zamkniętymi modelami. Jego dojrzałości nie należy mierzyć liczbą efektownych demonstracji, lecz możliwością niezależnego odtworzenia, ujawnieniem pełnej polityki atestacji, szybką reakcją na podatności sprzętowe i jasnym raportem o tym, czego test nie obejmował. Największą wartością będzie nie aura „bezpiecznej skrzynki”, ale audytowalny podział odpowiedzialności.
Życie benchmarku po pierwszym bezpiecznym uruchomieniu
Poufność nie kończy się wraz z usunięciem enklawy. Trzeba ustalić, kto zachowuje raport, czy producent może testować kolejne checkpointy, kiedy pojedyncze wyniki wolno ujawnić i po ilu uruchomieniach benchmark uznaje się za częściowo skażony. Nawet bez dostępu do pytań powtarzane eksperymenty z jedną metryką dają sygnał zwrotny, który może kierować strojenie modelu. Limit prób oraz jawny rejestr ocen są więc częścią ochrony niezależności testu.
Każdy raport powinien wiązać wynik z hashem modelu, wersją benchmarku, polityką atestacji i momentem weryfikacji. Gdy zmienia się sterownik, firmware, kod oceny lub sposób agregacji, porównanie z poprzednim wynikiem wymaga ponownego uzasadnienia. Dobrze zarządzany protokół tworzy łańcuch pochodzenia, a nie jednorazową odznakę. Pozwala odbiorcy odróżnić świeży, odtwarzalny pomiar od liczby, która nadal krąży w prezentacjach mimo zmiany badanego systemu.
Spór potrzebuje procedury ujawniania, zanim pojawi się wynik
Poufna ewaluacja staje się najtrudniejsza nie podczas poprawnego uruchomienia, lecz wtedy, gdy strony inaczej interpretują słaby wynik. Jeszcze przed testem powinny więc zatwierdzić kartę sporu: kto może zgłosić zastrzeżenie, jakie dowody są dopuszczalne, kto pełni rolę bezstronnego depozytariusza i które zdarzenia zatrzymują publikację. Karta powinna rozdzielać zarzut dotyczący benchmarku, modelu, infrastruktury oraz sposobu agregacji. Dzięki temu producent nie może podważyć całej oceny ogólnym stwierdzeniem, a evaluator nie może traktować poufności jako powodu do odmowy każdej kontroli. Zapisany z góry proces chroni także słabszą stronę organizacyjną, ponieważ dostęp do odwołania nie zależy od siły negocjacyjnej po ogłoszeniu wyniku. Właściciele aktywów powinni również zadeklarować konflikty interesów i wskazać osoby wyłączone z podejmowania decyzji.
Ujawnianie warto prowadzić warstwowo. Najpierw strony otrzymują publiczne podsumowanie, które oddziela uzgodnione fakty, otwarte zastrzeżenia i interpretację wyniku. Jeżeli to nie wystarcza, neutralny recenzent uzyskuje w kontrolowanym środowisku dostęp wyłącznie do artefaktu potrzebnego do rozstrzygnięcia konkretnego zarzutu. Zakres można poszerzyć dopiero po zapisaniu, dlaczego poprzednia warstwa nie pozwoliła odpowiedzieć na pytanie. Każdy krok powinien mieć właściciela, uzasadnienie, ślad decyzji i z góry ustalony moment ponownej oceny. Korekta nie powinna nadpisywać pierwotnego raportu; lepiej dołączyć podpisany aneks związany z wersją modelu, benchmarku i polityki wykonania. Taki rejestr zachowuje historię bez publicznego odsłaniania tajnych promptów lub wag. Dojrzałość protokołu poznaje się nie po braku sporów, lecz po tym, czy rozbieżność można rozstrzygnąć bez jednostronnego ogłoszenia prawdy i bez wycieku aktywu drugiej strony. Procedura musi też określać skutek braku konsensusu: wspólna nota z równoległymi stanowiskami jest uczciwsza niż wymuszone, pozorne uzgodnienie.
Najczęstsze pytania
Co oznacza „podwójnie ślepa” ewaluacja AI?
Producent modelu nie widzi prywatnych pytań, a evaluator nie otrzymuje wag ani poufnego kodu inferencji. Oba zasoby spotykają się dopiero w atestowanej enklawie, która zwraca wcześniej uzgodniony wynik.
Czy taki test dowodzi, że model jest bezpieczny?
Nie. Protokół wzmacnia poufność i integralność przebiegu. Bezpieczeństwo wniosku nadal zależy od jakości benchmarku, zakresu testu, wersji modelu i tego, czy wynik przenosi się na realne użycie.
Czy enklawa usuwa potrzebę zaufania?
Nie, lecz przenosi i ogranicza zaufanie. Strony nadal polegają na sprzęcie, firmware, atestacji i przejrzanym kodzie. Zaletą jest możliwość dokładnego opisania tej bazy oraz sprawdzenia uruchomionej konfiguracji.
Kiedy koszt takiego protokołu ma sens?
Gdy benchmark zawiera wrażliwe dane lub szybko traci wartość po ujawnieniu, a przekazanie wag modelu jest nieakceptowalne. Dla publicznego, rutynowego testu narzut koordynacji może przewyższać korzyść.