Ewaluacja AI
Porównanie modeli, testy jakości odpowiedzi i analiza błędów. Wynik: czytelny obraz możliwości i ograniczeń systemu.
↗
Mateusz WięcekAI · Lifestyle
Ewaluacja AI · Machine learning · RAG
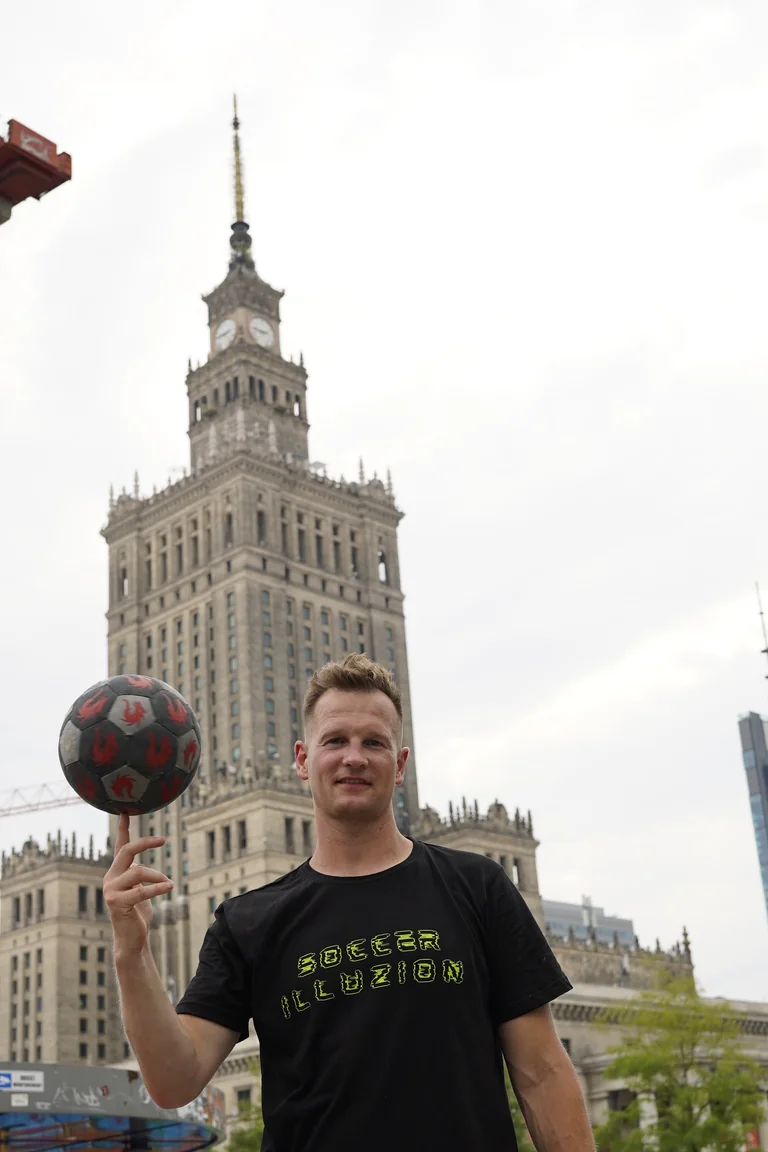
Buduję i testuję systemy AI: od wyszukiwania w dokumentach po modele rozpoznające obrazy. Pokazuję, co działa, gdzie system się myli i co warto poprawić. Wnoszę też doświadczenie ze sportu i prowadzenia zespołów.
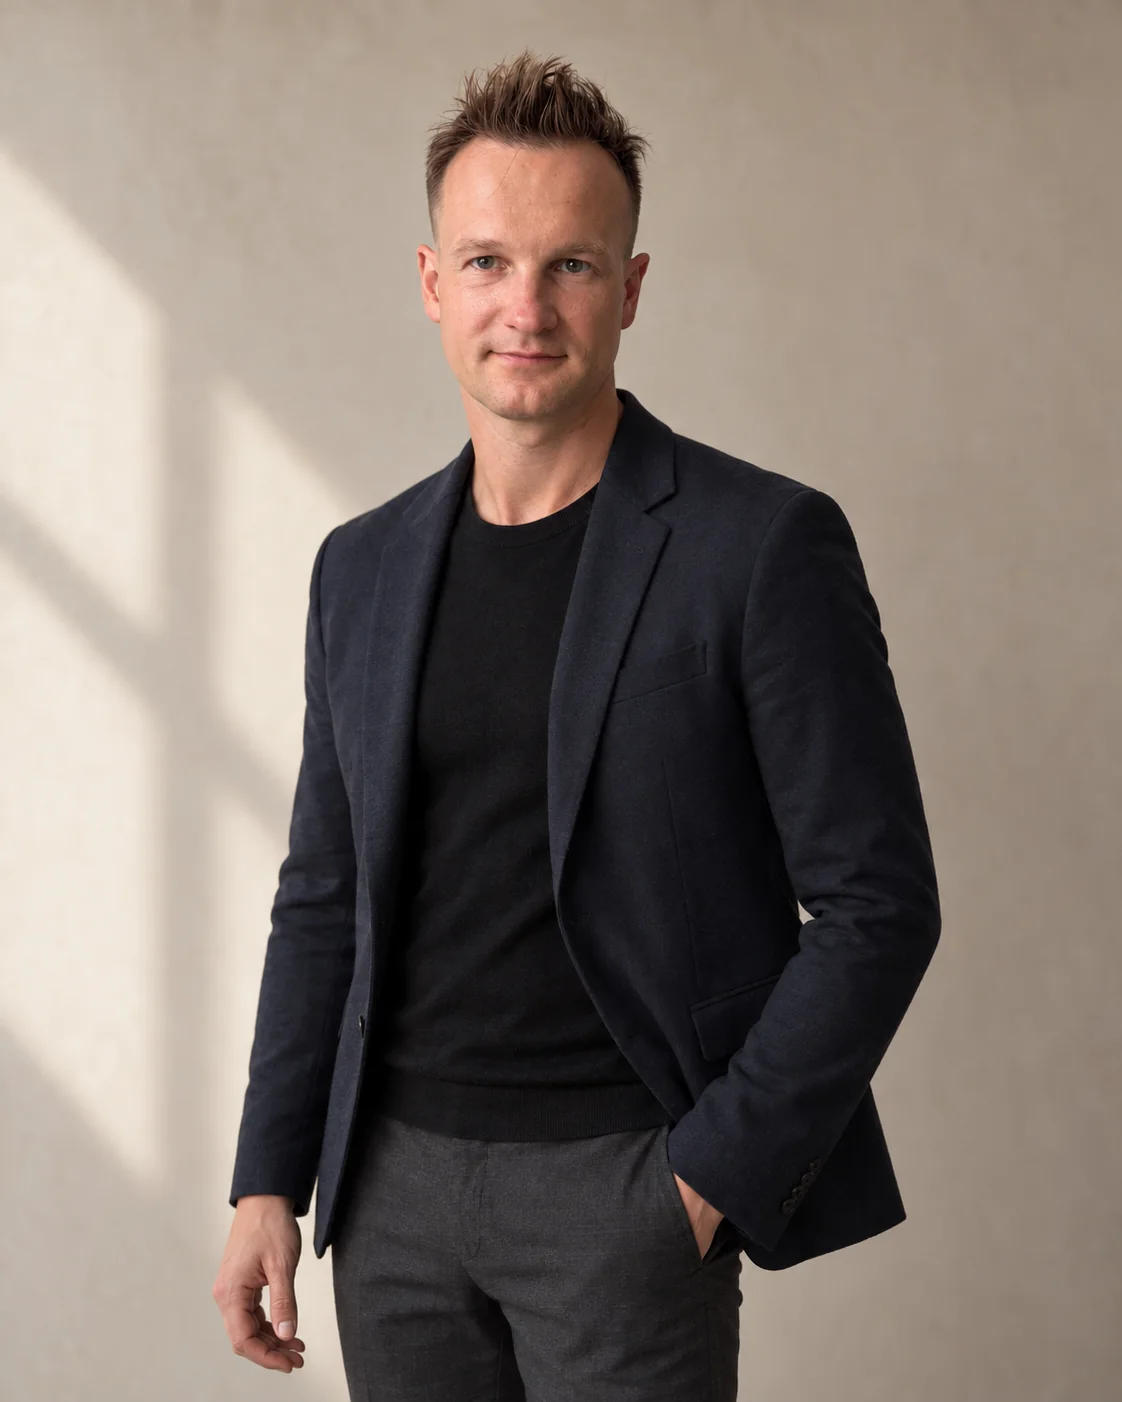
Strathclyde, AWF i Smile Camp. Techniczna precyzja spotyka energię sportu i doświadczenie pracy z ludźmi.
O mnie
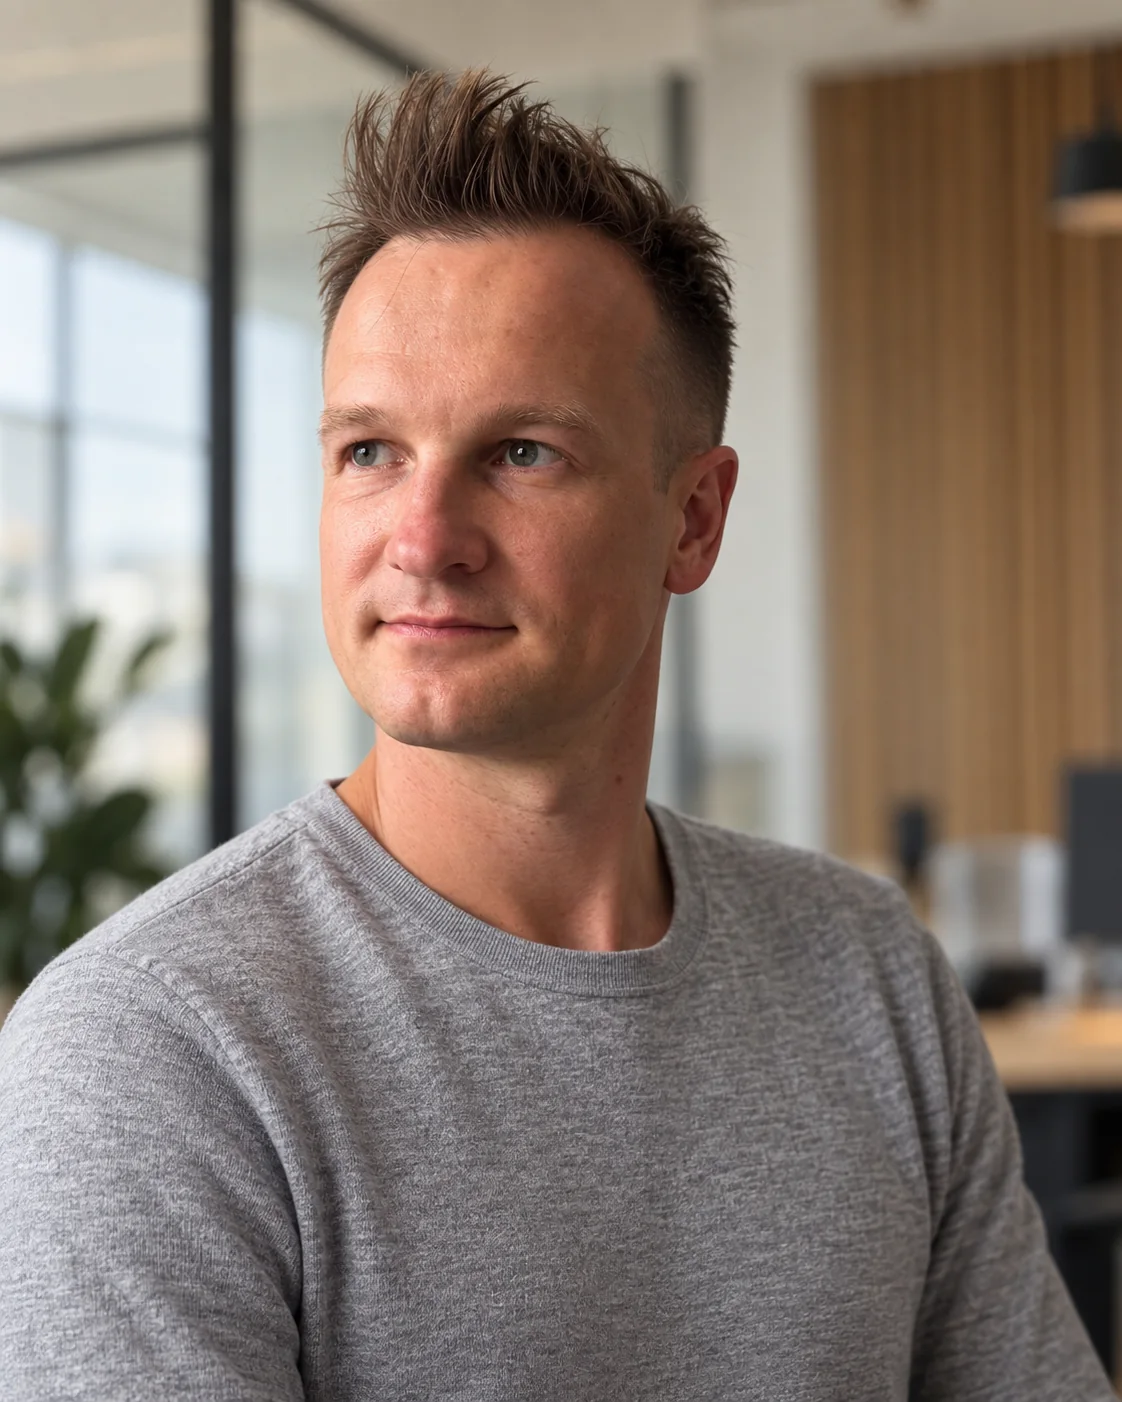
Ukończyłem wymagania programu MSc Artificial Intelligence and Applications na University of Strathclyde. Czekam na formalne przyznanie stopnia. Moja droga prowadzi od AWF, piłki nożnej i prowadzenia grup do budowania systemów AI. Łączy te światy ciekawość, cierpliwość i odpowiedzialność za rezultat.
W czym mogę pomóc
Szukasz wsparcia w projekcie AI lub osoby do zespołu? Takie problemy rozwiązuję w swoich projektach.
Porównanie modeli, testy jakości odpowiedzi i analiza błędów. Wynik: czytelny obraz możliwości i ograniczeń systemu.
↗Prototypy wyszukiwania w dokumentach, klasyfikacji i predykcji. Wynik: powtarzalny eksperyment z kodem i metrykami.
↗Łączę pracę techniczną z doświadczeniem w prowadzeniu grup sportowych. Wyjaśniam złożone pomysły i porządkuję kolejne kroki.
↗Dowody zamiast obietnic
Wybrane metryki z projektów akademickich. Każda liczba ma określony zbiór danych, metodę ewaluacji i ograniczenia.
Jak pracuję
Nie traktuję wyniku modelu jak dekoracji. Najpierw definiuję, co naprawdę mierzymy, potem buduję powtarzalny eksperyment i pokazuję rezultat razem z jego ograniczeniami.
retrieval na syntetycznym zbiorze EHR
Metoda i ograniczenie +Jak testowano: Qrels oraz jawne metryki P@3, R@3 i MRR dla patient-specific retrieval.
Granica: Nie oznacza 100% jakości odpowiedzi ani skuteczności klinicznej. Dane są syntetyczne.
Źródło projektu ↗główny wynik na oryginalnych etykietach
Metoda i ograniczenie +Jak testowano: Sieć feed-forward od podstaw w NumPy, regularizacja, early stopping i analiza błędów.
Granica: Wyrównanie etykiet daje diagnostyczne 88,62%; nie zastępuje głównego wyniku 45,84%. To benchmark obrazów, nie rozpoznawanie gestów z kamery.
Źródło projektu ↗raportowany błąd modelu regresyjnego
Metoda i ograniczenie +Jak testowano: CatBoost, baseline’y, inżynieria cech, walidacja, figury diagnostyczne i testy.
Granica: Wynik zależy od zbioru i skali celu; nie jest miarą systemu rekomendacyjnego.
Źródło projektu ↗przy maksymalnym obsunięciu 9,99%
Metoda i ograniczenie +Jak testowano: Chronologiczny train/test, koszty transakcyjne i porównanie z kilkoma baseline’ami.
Granica: Eksperyment historyczny, nie prognoza przyszłych zwrotów ani porada inwestycyjna.
Źródło projektu ↗Doświadczenie
Od pracy z ludźmi i komunikacją, przez wymagające operacje, po reprodukowalne systemy AI — każde z tych doświadczeń uczy odpowiedzialności za rezultat.
2012—dziś · sezonowo
Od 2012 roku sezonowo współtworzę doświadczenie Smile Camp, łącząc prowadzenie obozów i zajęć sportowych ze wsparciem strony internetowej oraz komunikacji cyfrowej.
Poznaj kadrę↗2025–2026 · oczekiwanie na przyznanie stopnia
Artificial Intelligence and Applications. Od eksperymentów z sieciami neuronowymi po pracę magisterską o wyszukiwaniu dowodów w dokumentacji klinicznej.
Poznaj moją drogę i badania↗2019—dziś
Praca w środowisku wysokiego tempa, wymagająca dokładności tras, zgodności z procedurami, samodzielnych decyzji i sprawnego rozwiązywania wyjątków.
Więcej niż wizytówka
Cztery wejścia prowadzą od krótkiej prezentacji do sprawdzalnych projektów, aktualnego kierunku i materiałów do publikacji.
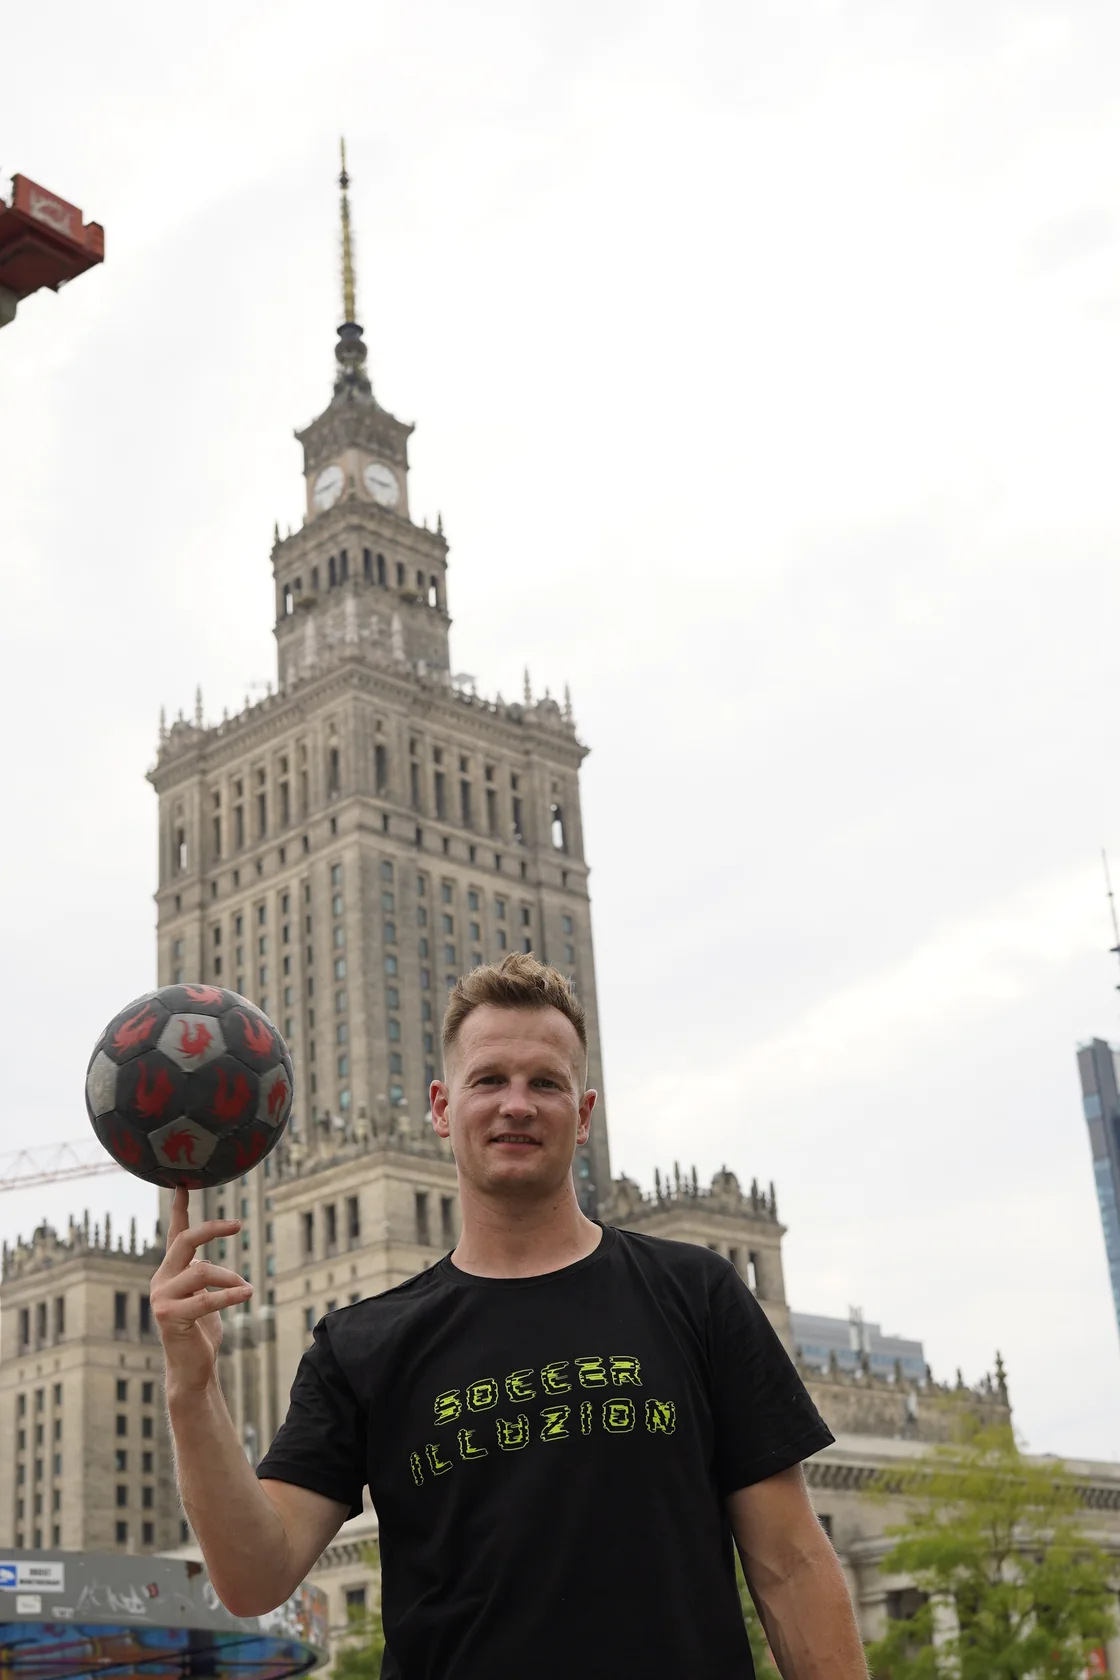
Poza ekranem
Sport nie jest dodatkiem do mojej pracy. Wykształcenie na AWF, piłka nożna, freestyle football oraz prowadzenie grup dzieci i młodzieży uczą mnie koncentracji, spokoju i odpowiedzialności za ludzi — tych samych cech, które wnoszę do technologii.
Ruch, koncentracja i konsekwencja.
Prowadzenie grup i budowanie dobrej atmosfery.
Łączenie odległych dziedzin w nowe pomysły.
Najnowsze idee
Sport, trzy projekty ze Strathclyde i mały eksperyment z analizą pozy. O tym, dlaczego dobry wynik potrzebuje uczciwego kontekstu.
Czytaj→Jak kryptograficzna enklawa pozwala niezależnie testować zamknięty model bez ujawniania ani wag, ani pytań.
Czytaj→Co ujawnienie Anthropic mówi o izolacji, uprawnieniach i monitorowaniu długo działających agentów AI.
Czytaj→Zacznijmy rozmowę
Projekt AI, oferta pracy, edukacja lub sport? Napisz, nad czym pracujesz, jaki masz cel i jakiego wsparcia szukasz. Możemy rozmawiać po polsku lub angielsku.
Wyślij mi wiadomość lub zaproszenie z krótkim opisem sprawy. Projekty i kod możesz przejrzeć przed rozmową.
Przejdź do LinkedIn↗Zobacz projekty i wyniki→