Dwa światy, podobny nawyk
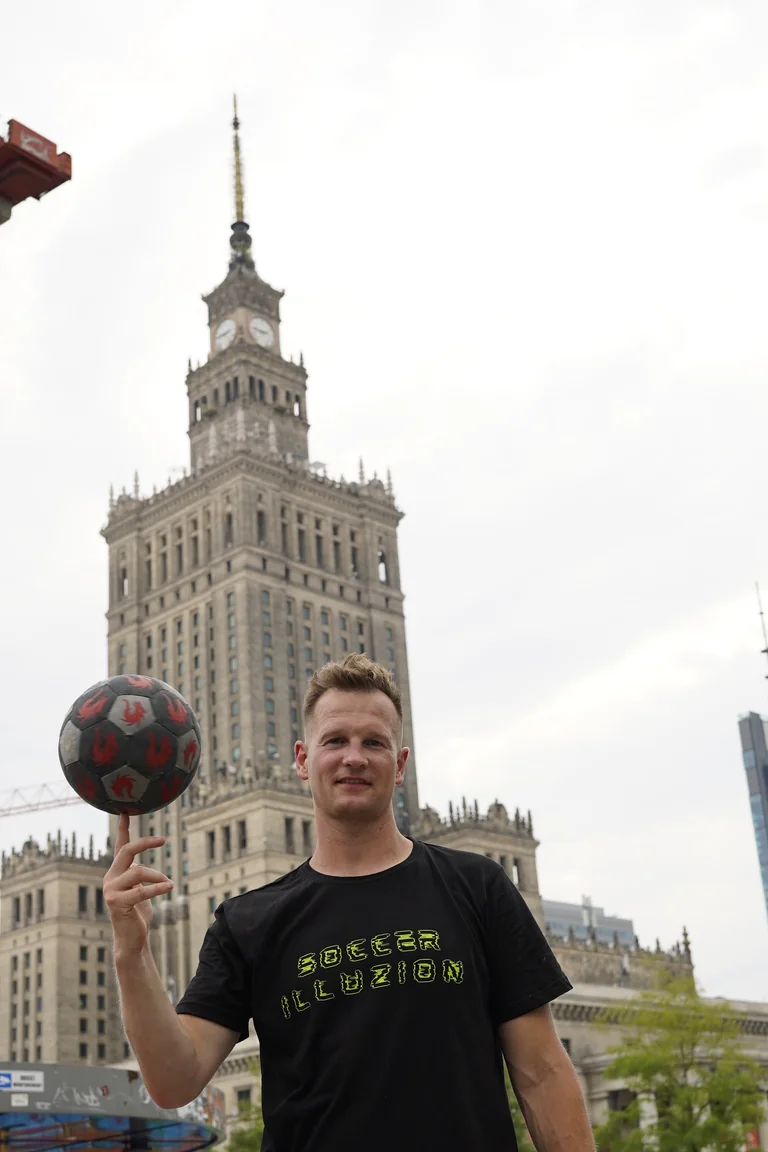
Sport i sztuczna inteligencja mogą wyglądać jak dwa oddzielne rozdziały. U mnie łączą je cierpliwość, powtarzanie prób i ciekawość tego, co nie zadziałało. W freestyle niewielka zmiana momentu ruchu ma znaczenie. W eksperymencie z modelem równie istotny bywa szczegół: sposób podziału danych, mapowanie etykiet albo wybór punktu odniesienia.
Wykształcenie na AWF i praca z grupami nauczyły mnie zwracać uwagę na proces. Na University of Strathclyde dołożyłem do tego narzędzia uczenia maszynowego i ewaluacji. Nie oznacza to, że sport jest dowodem kompetencji technicznych. Jest częścią mojej historii i sposobu, w jaki podchodzę do uczenia się.
Zanim poprawię wynik, nazywam zadanie
Liczba ma sens dopiero wtedy, gdy wiadomo, na jakie pytanie odpowiada. Czy oceniam odnalezienie właściwego dokumentu, klasyfikację obrazu czy przewidywanie wartości liczbowej? Nawet w obrębie jednego projektu odpowiedzi mogą wymagać różnych metryk. Chcę wiedzieć, co wynik rzeczywiście wspiera i jaki wniosek wykracza poza przeprowadzony test.
W praktyce zapisuję zadanie, dane, punkt odniesienia i kryterium oceny. Dopiero potem interpretuję rezultat. Dzięki temu atrakcyjna liczba nie odrywa się od warunków, w których powstała. Ten sam opis powinien pozostać widoczny w portfolio, także gdy zajmuje więcej miejsca niż sam procent.
Od pytania do uczciwego wniosku
Proponowany przeze mnie porządek pracy.
- 01Zadanie
Co chcę ustalić?
- 02Punkt odniesienia
Z czym porównuję?
- 03Test
Jakie dane i etykiety?
- 04Granice
Czego wynik nie dowodzi?
Clinical RAG: znaleziony fragment to jeszcze nie dobra odpowiedź
Publiczny Clinical RAG wykorzystuje syntetyczne fragmenty dokumentacji, wyszukiwanie TF-IDF, filtr pacjenta i odpowiedzi szablonowe z cytowaniami. Raportowane Recall@3 wynosi 1,000, a Precision@3 — 0,583. Pierwsza liczba mówi o odnalezieniu oznaczonych dowodów w tym zbiorze. Druga pokazuje, że wśród zwróconych fragmentów są też takie, które nie są trafne.
Nie nazywam tego stuprocentową jakością odpowiedzi. Retrieval, zgodność odpowiedzi ze źródłem i zachowanie przy braku dowodu to różne problemy. Dodatkowo ten publiczny prototyp nie jest produktem klinicznym. Ograniczenie zakresu twierdzenia jest częścią uczciwego opisu wykonanej pracy.
Sign Language MNIST: zachować także trudniejszą liczbę
W projekcie sieci neuronowych od podstaw wynik na oryginalnych etykietach testowych wynosi 45,84%. Diagnostyczne wyrównanie mapowania etykiet daje 88,62%. Można byłoby pokazać tylko wyższą wartość, ale wtedy znika najciekawsza część pracy: próba wyjaśnienia różnicy.
Dlatego główny wynik i diagnostyka powinny być opisane osobno. Diagnostyczna interpretacja nie zmienia automatycznie oryginalnego testu w lepszy test. Żeby pójść dalej, potrzebna jest niezależna weryfikacja etykiet. Ten przykład przypomina mi, że analiza błędów jest pełnoprawnym rezultatem projektu, nawet gdy nie kończy się jedną efektowną liczbą.
Spotify: porównywać to, co można porównać
W modelowaniu popularności muzyki publiczny benchmark CatBoost ma RMSE 6,52657, a szybka lokalna walidacja — 9,8633. Te wartości pochodzą z różnych warunków oceny. Ich zestawienie pomaga pokazać kontekst, ale nie jest dowodem pogorszenia modelu o konkretną wielkość. Różni się także rola każdego zbioru.
Podobnie dodatkowa złożoność nie musi przynieść korzyści. Wariant klasyfikacji z cechami tekstowymi TF-IDF pozostał eksperymentem, ponieważ domyślny Linear SVC na danych tabelarycznych miał lepszy odtwarzalny wynik walidacji. W portfolio warto pokazać powód tej decyzji, nie tylko nazwę wybranego narzędzia.
Movement Lab: mały eksperyment na własne oczy
Na tej stronie można teraz sprawdzić Movement Lab. Gotowy model MediaPipe szacuje punkty ciała na zdjęciu lub wybranej klatce filmu. Mój wkład obejmuje lokalny przepływ w przeglądarce, sposób pokazywania punktów, progi widoczności i geometrię kątów. Modelu nie trenowałem od zera — to istotne rozróżnienie.
Zdjęcie przykładowe pokazuje górną część sylwetki. Jeśli kolana są poza kadrem, interfejs powinien pokazać kreskę zamiast przekonującej liczby. Kąt wyliczony na obrazie 2D zależy od ustawienia kamery. To dobry punkt wyjścia do rozmowy o computer vision, ale nie pomiar biomechaniczny ani ocena jakości treningu.
Pięć pytań, które zabieram do kolejnego projektu
Co dokładnie próbuję ustalić? Z jakim prostym rozwiązaniem porównuję model? Czy dane testowe i ich etykiety są wiarygodne? W jakich przypadkach system się myli? Jaką informację musi zobaczyć człowiek, żeby prawidłowo odczytać wynik? Te pytania porządkują pracę znacznie wcześniej niż wybór najnowszej biblioteki.
Przygotowanie odpowiedzi wymaga więcej niż uruchomienia kodu. Trzeba zachować konfigurację eksperymentu, nazwać ograniczenia i pokazać źródła. Czasem następnym krokiem będzie większy model. Innym razem lepsze etykiety, prostsza metoda albo decyzja, że dostępny materiał nie pozwala na mocniejszy wniosek.
Technologia z miejscem na człowieka
Ukończyłem wymagania MSc Artificial Intelligence and Applications i czekam na formalne przyznanie stopnia. Chcę rozwijać tę stronę jako miejsce, w którym można zobaczyć moją pracę i zrozumieć osobę stojącą za nią. Dlatego obok kodu i wyników jest tutaj sport, Smile Camp i codzienna ciekawość.
Moim celem jest opowiadać o AI tak, żeby czytelnik mógł sam sprawdzić podstawę wniosku. Jeśli zaczynasz od Movement Lab, porównaj dwa kadry i zobacz, co zmienia się wraz z widocznością sylwetki. Jeśli interesują Cię projekty, zajrzyj do raportów. Każda z tych dróg może być początkiem dobrej rozmowy.